AI personale
Sviluppare, sperimentare e usare modelli in locale. Partiamo da software, modello e memoria.
Esplora i sistemiAI SYSTEMS
Dal personal AI computer al rack custom. Con BrunCos puoi acquistare il sistema che cerchi e costruire il progetto intorno a ciò che deve eseguire. Curiamo selezione, fornitura, configurazione e integrazione.
PARTI DAL TUO OBIETTIVO
Sviluppare, sperimentare e usare modelli in locale. Partiamo da software, modello e memoria.
Esplora i sistemiCondividere modelli e servizi. Valutiamo utenti simultanei, latenza, accessi e continuità.
Valuta un server GPUIntegrare compute, storage, rete, power e cooling. Dal rack al sito che lo ospita.
Progetta l’infrastrutturaVuoi acquistare un personal AI computer? Scegli il modello e segnalaci il tuo interesse: BrunCos prepara una proposta con configurazione, prezzo e tempi di consegna. Puoi partire anche da un solo dispositivo.
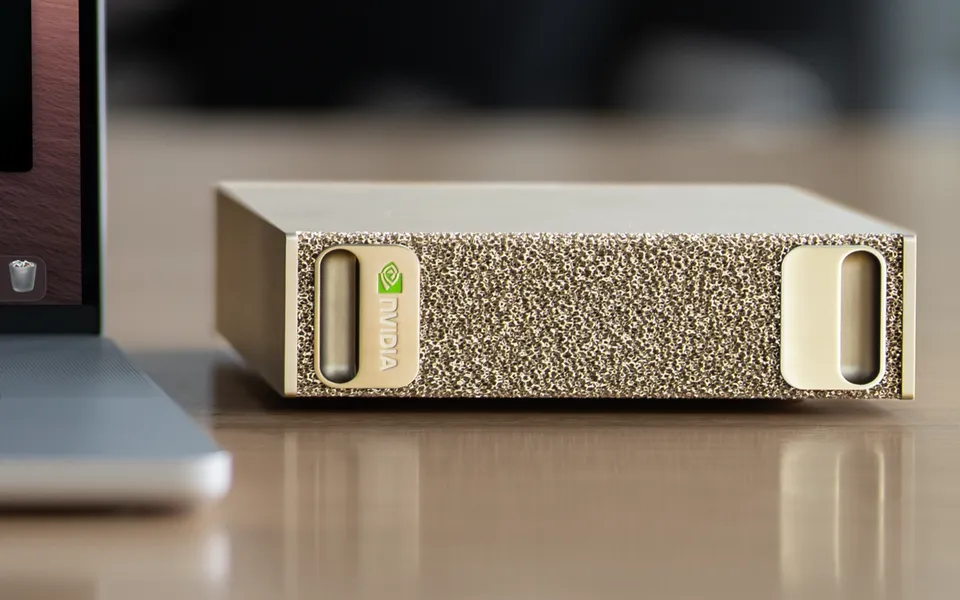
Una piattaforma Grace Blackwell compatta per prototipare, eseguire e adattare modelli AI in locale.
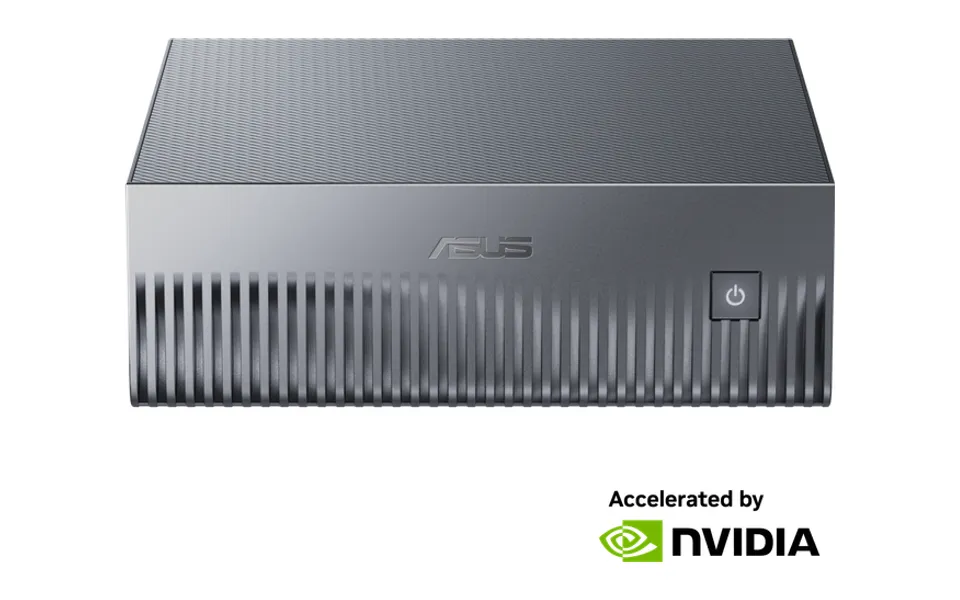
Sistema desktop GB10 con memoria unificata e connettività ConnectX-7, per ambienti di sviluppo AI.
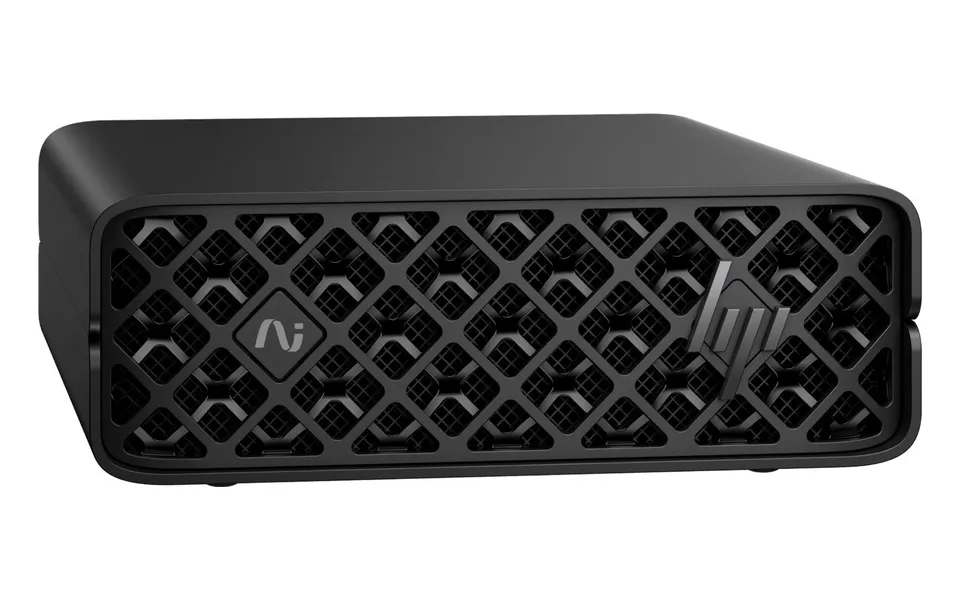
Una AI station compatta per prototipazione, fine-tuning e inferenza. Configurazione di riferimento CZ9J6ET#ABZ.
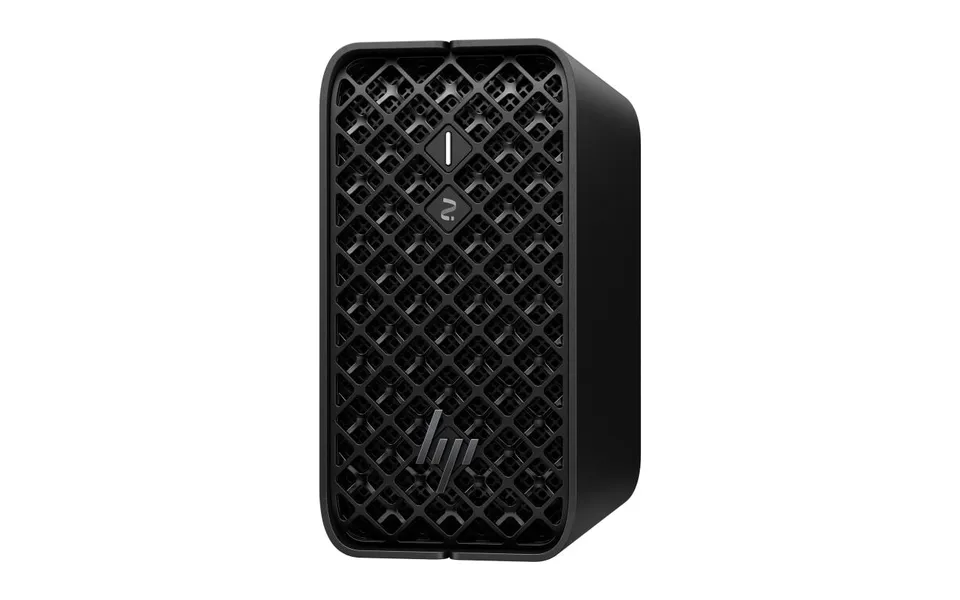
Workstation compatta basata su AMD Ryzen AI Max PRO. Da valutare sul framework e sulla compatibilità del workload.
Ti aiutiamo a scegliere la configurazione adatta al tuo modello, alla memoria richiesta e al software che utilizzi.
Confronta memoria, ambiente software e possibilità di crescita. BrunCos ti aiuta a scegliere il sistema da acquistare e la configurazione adatta.
Scorri orizzontalmente per confrontare software ed espansione →
| Sistema | Memoria | Software | Espansione |
|---|---|---|---|
| DGX SparkNVIDIA | 128 GB LPDDR5x unificata | DGX OS · Linux / Arm64 / CUDA. Verificare immagini e dipendenze Arm64 del progetto. | 128 GB sulla piattaforma; crescita tramite rete e nodi, con software distribuito compatibile.Fonte tecnica ↗ |
| Ascent GX10ASUS | 128 GB LPDDR5x unificata | DGX OS · Linux / Arm64 / CUDA. È il sistema operativo testato e consigliato da ASUS. | Storage da scegliere per SKU. Più nodi collegabili via rete; memoria non aggregata automaticamente.Fonte tecnica ↗ |
| ZGX Nano G1n AI StationHP | 128 GB unificata | DGX OS · Ubuntu / Arm64 / CUDA. Validare il runtime sulla configurazione selezionata. | 128 GB unificati e storage secondo configurazione. ConnectX-7 per integrazione e rete tra nodi.Fonte tecnica ↗ |
| Z2 Mini G1aHP / AMD | Fino a 128 GB LPDDR5x · secondo SKU | x86-64 · Windows 11 Pro disponibile nella gamma. Supporto GPU AMD da verificare per runtime e sistema operativo. | RAM integrata da scegliere all’ordine; NVMe configurabile. Per GPU discrete espandibili valutiamo una workstation custom.Fonte tecnica ↗ |
La memoria unificata è condivisa con sistema operativo e applicazioni: non coincide con memoria interamente disponibile al modello. La compatibilità si verifica sulla combinazione di hardware, sistema operativo e runtime.
Serve più espandibilità? Le workstation BrunCosINSIDE THE SYSTEM
AMD Ryzen AI e Intel Core Ultra integrano più motori di calcolo. Nei server, AMD EPYC e Intel Xeon affiancano le GPU o eseguono direttamente workload compatibili. Partiamo dal software per scegliere la piattaforma.
Gestisce applicazioni, dati e servizi. Può eseguire anche inferenza, in funzione del modello e della latenza richiesta.
Elabora molti calcoli insieme: centrale per training e inferenza intensiva. Memoria e compatibilità software guidano la scelta.
Accelera inferenza locale con attenzione ai consumi, quando modello e software la supportano. Non sostituisce una GPU per ogni carico.
Ryzen AI Max+ PRO 395
CPU, grafica Radeon integrata e NPU AMD XDNA 2 nello stesso processore.
Da valutare per workstation compatte, sviluppo e modelli locali con memoria condivisa.
Memoria assegnabile alla GPU, sistema operativo e supporto del runtime per il modello scelto.
AMD Ryzen AI Max+ PRO 395 ↗AMD · Ryzen AI PRO ↗Fonti verificate il . BrunCos seleziona e configura il sistema completo intorno alla piattaforma più adatta.
Core Ultra X7 358H
CPU, GPU Intel Arc B390 e NPU Intel AI Boost nella piattaforma di riferimento.
Da valutare per AI PC e sistemi edge: inferenza locale su CPU, GPU o NPU attraverso runtime compatibili, come OpenVINO.
Dispositivo OEM, memoria, driver e operatori del modello supportati da ciascun acceleratore.
Intel Core Ultra X7 358H ↗Intel · AI Boost NPU ↗Fonti verificate il . BrunCos seleziona e configura il sistema completo intorno alla piattaforma più adatta.
5th Gen EPYC
CPU server per elaborazione dati, inferenza su CPU e nodi che ospitano acceleratori GPU.
Da valutare per servizi AI condivisi, pipeline dati e server GPU. Anche la CPU può eseguire il modello quando i requisiti lo consentono.
Core, canali di memoria, linee PCIe, consumi e latenza sul carico reale.
AMD EPYC 9005 ↗AMD EPYC · AI inference ↗Fonti verificate il . BrunCos seleziona e configura il sistema completo intorno alla piattaforma più adatta.
Xeon 6980P · Intel AMX
CPU server con Intel Advanced Matrix Extensions per accelerare le operazioni matriciali dei workload AI compatibili.
Da valutare per inferenza su CPU, servizi enterprise e nodi GPU. AMX è una capacità della CPU, distinta dalla NPU degli AI PC.
SKU con P-core, supporto AMX nel software, memoria, topologia e potenza del sistema.
Intel Xeon 6980P ↗Intel AMX ↗Fonti verificate il . BrunCos seleziona e configura il sistema completo intorno alla piattaforma più adatta.
Un valore TOPS non basta per scegliere. Precisione numerica, memoria, software e condizioni di misura devono essere comparabili. Verifichiamo tempi di risposta, utenti simultanei e consumi sul tuo workload.
Ogni macchina parte da un carico reale. Scegliamo GPU NVIDIA o AMD in base alla toolchain, alla memoria richiesta e al ciclo di utilizzo.
Un ambiente dedicato per sviluppo AI, coding agents, LLM locali e computer vision.
Modello, memoria e toolchain
Progetta con BrunCosPer team tecnici, rendering e AI. Valutazione multi-GPU in funzione del software e degli interconnect.
Parallelismo e flussi di lavoro
Progetta con BrunCosUna configurazione su progetto per workload più esigenti, con attenzione a potenza, termica ed espandibilità.
Capacità, potenza e termica
Progetta con BrunCosWorkstation BrunCos su misura: definiamo componenti, configurazione e collaudo in base al tuo lavoro, con una proposta dedicata.
Dall’inferenza condivisa ai workload più intensivi: costruiamo il server a partire da capacità, concorrenza e continuità richieste.
2GPU
Inference e servizi AI per team e PMI.
Configura con BrunCos4GPU
Più workload, utenti e capacità di elaborazione.
Configura con BrunCos8GPU
Ricerca, training e inferenza intensiva su progetto.
Configura con BrunCosLE VARIABILI DEL PROGETTO
GPU / CPU / RAM / VRAM / NVMe / Network / Power / Cooling / Software stackIl numero di GPU identifica una classe di progetto. Memorie di più GPU non si sommano automaticamente: il software deve supportare la distribuzione del modello.
04 / CUSTOM AI RACKS
Progettiamo ciò che collega, alimenta, protegge e rende gestibili i server.
Misurazioni pubblicate da StorageReview, NVIDIA e Puget Systems: dati utili alla scelta, da leggere insieme al modello, alla configurazione e alle condizioni di ciascun test.
StorageReviewProva editoriale
NVIDIA DGX Spark · GB10 · 128 GB
Qwen3 Coder 30B-A3B · FP8
Concorrenza 1 e 64. Il secondo valore è il throughput totale di tutte le richieste, non la velocità per utente.
Runtime: vLLM
Lunghezze input/output e versione vLLM non indicate per questi risultati.
Divyansh Jain ·
Verificato:
NVIDIATest del produttore
NVIDIA DGX Spark · 128 GB
Qwen3.5 35B A3B · FP8
128K token in ingresso, 1K in uscita, batch 1. La latenza include elaborazione del prompt e generazione.
Runtime: vLLM
Valori rappresentativi pubblicati dal produttore; versione runtime non indicata.
Allen Bourgoyne ·
Verificato:
Puget SystemsTest di un integratore
2× AMD EPYC 9554 · 24×64 GB RAM · RTX 6000 Ada 48 GB
DeepSeek-R1 · Unsloth Q4_K_M
Prompt 2, circa 7.500 token in ingresso. Inferenza ibrida CPU/GPU: generazione con 126 e 254 thread CPU.
Runtime: KTransformers
Output di lunghezza variabile; versione runtime non indicata. Consumo elettrico non misurato.
Jon Allman ·
Verificato:
Nel tuo progetto misuriamo ciò che conta: tempo al primo token, velocità per utente, richieste simultanee e assorbimento alla presa, con il modello e il software concordati.
Definiamo il test del tuo workloadIL PROSSIMO PASSO